この記事の概要
Claude Opus 5.5とFable 5.1、結局どちらを既定にすればいいのか。Anthropic公式の推奨と、うちの1週間の実測(利用回数・週枠の減り方)を並べ、effort設定でOpus 5.5以降に効かない仕様まで含めて整理しました。
迷ったらOpus 5.5、Fable 5.1は「それでも足りない時」だけ
Claude Opus 5.5とClaude Fable 5.1、どちらを既定(デフォルトで使うモデル)にすればいいか迷っている方へ、先に結論を書きます。Anthropic公式のガイドは「不明な場合はほとんどの作業でOpus 5.5から始める。難しい推論や長時間の自律作業、またはOpus 5.5を高いeffort(推論の強さ)にしても評価基準に届かない時だけFable 5.1を使う」としています。
うちでも、2026年11月時点でこの推奨どおりの使い分けに落ち着いています。ただし、実際に1週間使ってみて分かった料金差、週の利用上限の減り方、effortの設定の落とし穴は、公式ページだけでは見えてきません。この記事では、公式の仕様と、うちの1週間の実測の両方を並べます。
実測についての注記: 以下の実測はうちの1社・1週間分の数字です。利用量や作業内容が違えば結果は変わるので、そのまま当てはめず「自分の環境で測る目安」として読んでください。
Opus 5.5とFable 5.1、何がどれだけ違うのか
2026年11月時点のAnthropic公式ページによると、両モデルの違いは次の表のとおりです。
Opus 5.5とFable 5.1の違い
| 項目 | Opus 5.5 | Fable 5.1 |
|---|---|---|
| API入力(100万トークン) | 4ドル | 10ドル |
| API出力(100万トークン) | 20ドル | 50ドル |
| コンテキスト | 100万トークン | 100万トークン |
| Claude Codeの既定effort | medium | high |
| 想定する作業 | 幅広い作業 | 難しい推論・長時間作業 |
2026年11月時点のAnthropic公式ページにもとづく比較です。
Claude APIの標準料金で見ると、Fable 5.1はOpus 5.5の2.5倍の単価です(言い換えると、Opus 5.5の単価はFable 5.1の4割)。これはAPIの単価の比較で、ClaudeアプリやClaude Codeの月額プランは条件が別です。コンテキスト(一度に読み込める文章量)はどちらも100万トークンで差がありません。大きな違いは「既定のeffort」と「想定する作業の種類」です。Fable 5.1は既定のeffortがhighで、難しい推論や、何十ステップにもわたる自律的な作業に向きます。Opus 5.5は既定がmediumで、必要な時だけ強度を上げて使います。
週の利用上限はどれだけ減るのか(1社の実測)
Fable 5.1の扱いは契約プランで違います。Max・Ultraなどの対象プランでは通常の週枠の最大50%まで使え、ほかのモデルより早く枠を消費すると公式が説明しています。Proでは通常の週枠に含まれず、最初からusage creditsによる従量課金です。以下はうちの環境の実測で、ほかのプランにそのまま当てはめることはできません。2026年9月25日から10月2日の1週間、メインの作業で使ったモデル別のやり取り回数(ターン数)を数えると、次のようになりました。
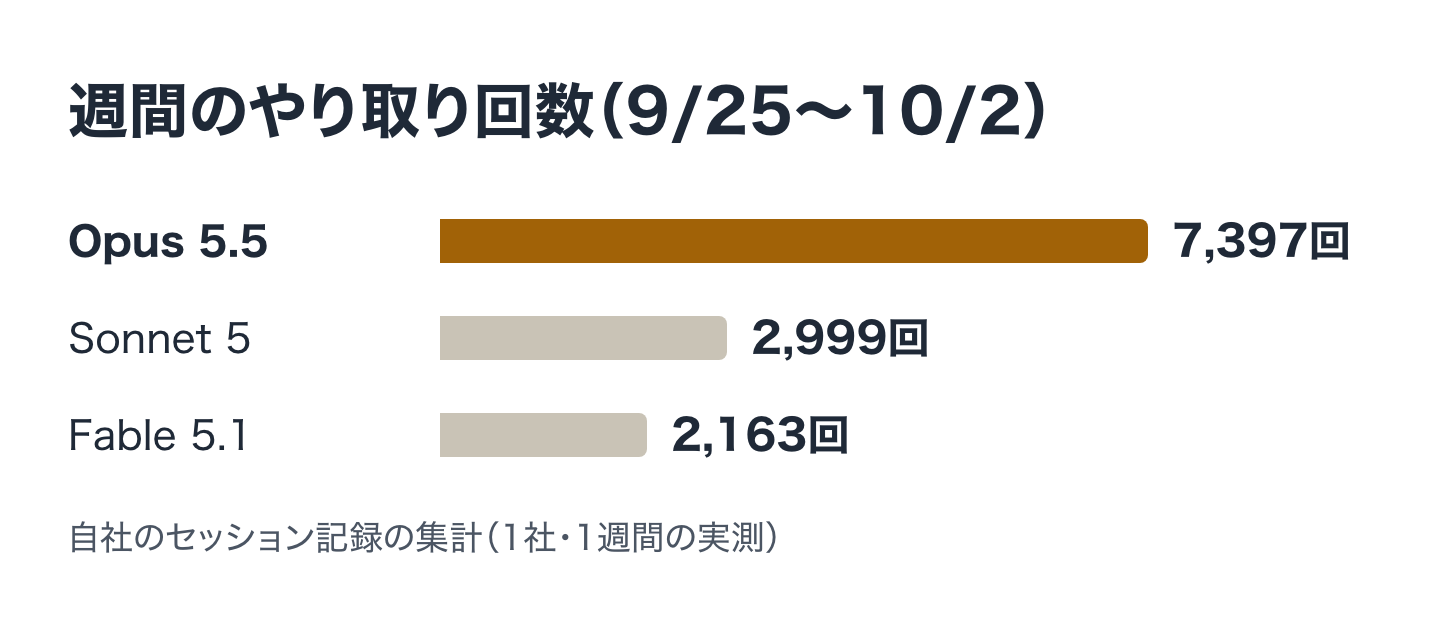
同じ週に、全モデルの週枠は週次リセットの53分前の時点で79パーセント、Fable 5.1だけの枠は54パーセントでした。前の週(9月24日時点の実測)は全モデル88パーセント・Fable枠73パーセントだったので、メインをOpus 5.5中心にした週の方が枠は軽く済んでいます。公式の説明どおり、Fable 5.1は週枠の減り方が大きいモデルだという実感です。もちろん、これは「うちの作業内容での1週間」の話で、コードを書く作業が多いか、文章を書く作業が多いかでも変わります。自分の環境で同じように数えてみることをおすすめします。
effortの設定で気をつけること
effort(推論の強さ)は、モデルがどれだけ考える時間をかけるかを決める設定です。ここでひとつ、知らないと戸惑う仕様があります。
ユーザー設定の最上位にあるeffortLevelという項目は、Opus 5.5とSonnet 5.5には効きません。Opus 5以前やFable 5.1には今までどおり効きますが、Opus 5.5は、ほかの指定がなければこの設定を無視してmedium(中程度)から始まります。
既定のmediumから上げたい場合は、次のいずれかで指定します。
- `/effort`コマンドでスライダーを開く、または`/effort high`のように直接指定する
- `/model`のモデル選択画面でスライダーを調整する
- プロジェクトの設定ファイル(ユーザー設定ではなくプロジェクト側)にeffortLevelを書く
- 無人で動かす場合は環境変数`CLAUDE_CODE_EFFORT_LEVEL`で指定する
「effortLevelを設定したのにOpus 5.5だけ反応が変わらない」と感じたら、まずこの仕様を疑ってみてください。無人で動かす定期実行のタスクでeffortを固定したい場合も、ユーザー設定ではなく環境変数かプロジェクト側の設定を使う必要があります。
Sonnet 5.5はどこに位置するか
OpusとFableの間には、もう一つ選択肢があります。Claude Sonnet 5.5です。公式ページでは「速さと知能の組み合わせが最もよいモデル」と説明されていて、料金は入力100万トークンあたり2ドル・出力10ドルで、Opus 5.5の半額です。
社内の作業を振り分けるなら、判断や検収のように精度を重視する場面はOpus 5.5、量をこなす機械的な作業や、サブエージェントに任せる並行処理はSonnet 5.5、というように料金と速さのバランスで振り分ける考え方もできます。Fable 5.1だけが特別に優れているわけではなく、3つのモデルを作業の性質に合わせて組み合わせる発想が、結局は無駄のない使い方につながります。
結局どう使い分けるか
まとめると、既定はOpus 5.5にして、次の条件に当たった時だけFable 5.1に切り替える、という運用が無理のない形です。
- Opus 5.5をeffort高めにしても、求めている精度に届かない
- 何十ステップにもわたる自律的な作業で、途中で思考が浅くなると困る
- 週の利用上限よりも、その1回の精度を優先したい
逆に、日常のコーディングや文章作成、短時間で終わる作業なら、Opus 5.5のままで十分なことがほとんどです。料金差と週枠の減り方を考えると、Fable 5.1は「ここだけは外せない」という場面に絞って使うのが合理的です。関連して、Claude Codeの土台となる仕組みの考え方は「AIエージェントの最新理論をガンダムで解説する」、Claude Code自体の基本的な導入は「Claudeが落ちても困らない環境を作る――Claudian導入ガイド」、同じ週のAI業界の動きは「OpenAI DevDay 2026まとめ 20以上の発表から、小さなAI組織が本当に使うものを選ぶ」でまとめています。
よくある質問
Claude Opus 5.5とFable 5.1、結局どちらを既定にすればいいですか。
Anthropic公式の推奨は「迷ったらOpus 5.5から始める。難しい推論や長時間の自律作業、またはOpus 5.5を高いeffortにしても評価基準に届かない時だけFable 5.1」です。うちでもこの推奨どおりの使い分けに落ち着いています。
料金はどれくらい違いますか。
2026年11月時点のClaude APIの標準料金は、100万トークンあたり、Opus 5.5が入力4ドル・出力20ドル、Fable 5.1が入力10ドル・出力50ドルで、Fable 5.1はOpus 5.5の2.5倍の単価です。これはAPIの単価なので、月額プランの場合は契約プランごとの扱いを別に確認してください。
Fable 5.1を使うと週の利用上限はどれくらい減りますか。
契約プランで扱いが違います。Max・Ultraなどの対象プランでは、通常の週枠の最大50%までFable 5.1を使え、ほかのモデルより早く枠を消費すると公式が説明しています。Proでは通常の週枠に含まれず、最初からusage creditsによる従量課金です。うちの1週間の実測も、この説明に合う動きでした。
effortの設定で気をつけることはありますか。
ユーザー設定の最上位にあるeffortLevelは、Opus 5.5とSonnet 5.5には効きません。既定のmediumから上げたい場合は、/effortコマンドやモデル選択画面のスライダー、プロジェクト側の設定、環境変数のいずれかで指定します。